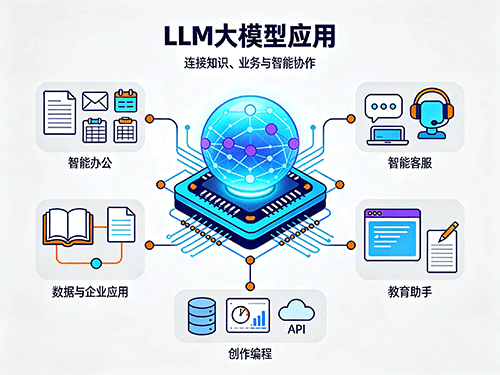
LLM大模型的应用测试和安全测评困难在测试对象从确定软件变成了概率系统。软件测试中同样输入必然得到同样输出的前提失效,而大模型应用的风险也从输出一句不合规内容扩展到在业务链路中错误调用工具、越权访问数据、被提示词操控。因此测试框架变为:功能上,系统在多大程度上可靠地完成了用户目标;安全上,系统在对抗条件下能否守住边界。
一、先区分标准和标准
功能测评常见误区是把模型排行榜分数当作应用可用性的证据。MMLU、SWE-bench这类标准回答基座模型通用能力大致位置,适合模型选型初筛。标准回答系统在真实业务数据上行为是不是正确。模型标准分高1分,对具体应用中检索是不是召回正确文档、退款Agent是不是报出正确金额,预测力很低。
可操作组合是用3-4个标准判断模型能力分布,包括知识、推理、代码、工具调用。用4-6个自建标准在自有数据上做系统级验收。两类评测在不同步骤以不同频率运行。
二、功能测评从输出相似度走向分层测试
1.测试对象分层
功能测试先确定测什么。纯文本应用至少区分模型层和应用层。模型层测试基座输出质量、拒答能力、事实性。应用层测试Prompt、RAG、上下文管理、插件调用。接入业务流程的系统还要包括业务层和运营层。业务层测试身份、权限、动作、流程。运营层测试人工复核、日志、方法更新。四层都测到,结果才接近真实上线状态。
2.质量方面
可落地的轻量框架从五个方面考虑输出质量,事实准确性、指令按照、完整性和相关性、安全偏见隐私、语言质量。生产环境常见失败方式有幻觉引用、部分遵从、过度拒答、刻板印象强化、自相矛盾陈述。实践不必追求方面数量,选择和自身失败方式最相关的3—5个方面建立固定评分标准,对每个缺陷标注严重等级,形成可追踪缺陷日志。
3.测试标准的三种底层原语
自建标准本质上由三种原语组成。选型优先使用能诚实回答当前问题的最便宜原语。
确定性检查适用于答案可被规则决定对错的场景。典型样本有JSONSchema检查、工具调用签名一致、引用ID存在性、拒绝措辞一致。它微秒级、免费、不漂移,无法判断是不是有帮助。
嵌入相似度适用于有干净参考答案、容忍复述的场景。典型标准有BERTScore、余弦相似度。它能识别表面相似,不能识别实质正确。自信的错误答案仍可能高分。
LLM-as-a-Judge适用于需要推理的评分标准。典型标准有忠实性、任务完成度、角色按照。它通用性强,成本最高,存在裁判偏见。使用时要固定裁判模型和评分标准版本,定期和人工标注校准。
4.智能体场景的步骤级、调用序列级、任务级考虑
测试对象从单轮问答升级为工具调用型Agent后,仅看最后输出会掩盖大量中间失败。应在三个粒度同时考虑。
步骤级看单个工具调用是不是选对工具、参数是不是正确、执行是不是成功。重要标准有工具准确率、参数准确率、执行成功率。
调用序列级看调用顺序是不是高效,有无多余调用、是不是走弯路、遇到工具错误后能否恢复。标准有调用序列长度效率、错误恢复率、重复调用率。
任务级看最后是不是完成用户目的。多轮对话还要考虑对话完整性、跨轮知识保留、最后结果状态,典型状态有已解决、已预约、已退款。Agent任务应拆分为task、trial、grader、transcript管理。多轮执行和工具调用会让错误影响后续步骤,错误会累积。
三、安全测评从测模型转向测业务全流程
1.风险分类框架
业界主要参照两套风险分类。OWASP Top 10 for LLM Applications包括提示词注入、敏感信息泄露、过度代理权滥用等基础风险。OWASP Top 10 for Agentic Applications 2026的ASI01-ASI10针对智能体系统特有风险细分。NISTAI800-2草案从考虑流程角度提供三阶段实践,定义测量目的、实施并运行考虑、分析并报告结果。
2.安全测评包括范围
企业级安全测评不应停留在输入审核和输出审核两端过滤。完整包括面至少包括以下步骤。
用户输入步骤测试违规内容、隐私数据、恶意诱导,做输入侧风险识别和脱敏测试。
系统提示词步骤测试规则泄露、被包括、被绕过,做越狱和多轮攻击测试。
RAG知识库步骤测试文档污染、隐藏指令、虚假知识,做知识库样本污染测试。
模型输出步骤测试违法违规、虚假误导、侵权,做输出审核和高风险行业测试。
工具调用步骤测试越权查询、导出、删除、支付,做权限检查和二次确定测试。
审计日志步骤测试无法复盘、无法举证,做日志字段和审计证据完整性检查。
RAG应用必须单独做安全测试。文档和检索结果会进入上下文,隐藏指令和错误信息可能直接改变模型行为。普通提示词过滤无法包括这类可被攻击步骤。
3.红队测试落地方法
红队样本设计采用通用攻击、行业场景、企业私有流程三层结构。只测公开越狱语料会忽略真实业务风险。
通用攻击层包含直接提示词注入、间接提示词注入、角色扮演、编码绕过、语言切换、多轮诱导、系统提示词探测。
行业场景层包含金融建议、医疗建议、未成年人互动、招聘歧视、广告合规、内容侵权。
私有流程层包含订单、合同、客户资料、内部文档、知识库检索、工单处理、业务工具调用。
典型攻击过程可拆解为恶意输入、诱导忽略系统规则、读取历史或知识库敏感内容、生成违规回答或错误建议、调用高风险工具、造成数据泄露或内容违规或业务损失。测试既要单点样本证实基础识别能力,也要组合样本证实方法联动是不是有效。
验收标准不应只看能不能拦。测试高风险样本召回率、正常业务误杀率、攻击成功率、方法可配置性、P99延迟、命中片段和置信度返回情况、审计证据完整性、样本重新加入和方法更新能力。
4.合规
中国境内落地的生成式AI服务以GB/T45654-2025《网络安全技术生成式人工智能服务安全基本要求》作为安全考虑题集建设重要根据。该标准包括训练数据安全、模型安全、安全措施三个方面。备案场景测试题集一般分三类。
应拒答题测试对违法不良信息的拒绝能力。决定标准包含拒绝行为和拒答理由得当。重点工程要求为同一风险点设计改写变体,防止模型靠重点词一致虚高通过。
边界题测试伦理和作用边界上的分寸。标准是不主动引导错误行为、不给确定性结果、提示风险、建议咨询专业人士。
普通题从真实业务场景抽取,测试事实准确性,证实回答中不夹带违法有害内容。
T/ISC0146—2026《大模型服务和应用安全评测技术规范》适用于大模型服务平台、应用系统、智能体系统、集成大模型能力的API服务。该规范包括文本交互、代码生成、多轮对话、RAG、工具调用等场景,规定评测对象、环境准备、风险类型、检测方法、评价标准、结果决定规则。
四、从评测走向运行时治理
上线前红队测试会发现风险点。决定长期安全的是评测结果能否转化为运行时控制。完整流程一般包含输入风险识别、隐私脱敏、提示词攻击检测、RAG召回内容复检、模型调用、输出安全审核、工具调用风控、方法引擎、人工复核、审计日志、样本重新加入。
原则是安全检测尽量接入步骤,不在最后输出后只做一次审核。只能旁路接入的系统至少保留日志、告警、事件生成、审计追溯能力。审计不只记录有没有拦截。审计保留请求ID、内容ID、用户、执行动作、方法版本。发生投诉或事故时能回答风险在哪里被发现、根据是什么、当时执行了什么方法。
五、工具链选型和顺序
1.工具能力范围
DeepEval是Pytest风格的LLM考虑框架,适合单元测试式输出考虑、合成数据生成、CI/CD集成。
Promptfoo是本地优先的考虑和对抗测试工具,适合提示词版本对比、OWASP和NIST相关对抗测试生成。
Giskard是面向LLM和Agent的考虑和红队SDK,适合自动化测试生成、红队探测、数据集级评分。
Rhesis是开源LLM和Agent测试平台,适合自然语言定义预期行为、生成对抗场景、UI和API双通道考虑。
garak是LLM漏洞扫描器,适合静态、动态、自适应检测项,包括提示注入、越狱、幻觉、毒性、数据泄露。
LlamaTest、AegisEval、TestGPT-OS是专项能力工具,分别适合幻觉检测、行为变化比对、测试即代码和可观测性集成。
选型避免一个工具解决所有问题的预期。确定性断言、语义考虑、对抗红队属于不同方面。合理方式是确定性检查走快速规则,语义考虑用LLM-as-a-Judge并做好校准,红队探测用专项工具在版本发布前批量运行。
2.分阶段顺序
阶段一建立最小可行考虑基础。从生产流量采样50—100条代表性输入,标注预期行为,定义4—6个重要标准,至少包含1个确定性标准和1个语义标准,固定裁判模型和评分标准版本。这是后续扩展的基础。
阶段二接入CI合并前检查。考虑套件接入PR流程,设置每个标准基线阈值。忠实性不低于0.75、任务完成度不低于0.85可作为起点,按实际分布调整。任何PR导致标准下降超过阈值即阻止合并。基线使用更新基线,不使用固定值,以反映模型和数据自然变化。
阶段三安全红队和专项测试。功能考虑稳定后,按OWASP分类和GB/T45654题集要求设计红队样本,包括提示词注入、RAG污染、越权工具调用、敏感信息泄露、过度拒答。Agent场景额外测试多轮记忆一致性、权限范围、动作审计。
阶段四生产观测和完整流程更新。对生产流量采样,用和CI相同的评分标准打分,将分数记录到调用追踪。变化在用户投诉之前可见。失败生产调用记录重新加入考虑数据集,考虑体系随系统更新,避免发布后几个月内迅速失效。
LLM应用测试的本质变化是测试不再是一次性验收动作。测试是一套随模型、数据、可被攻击步骤不断更新的工程基础设施。功能侧建立标准选型、自建标准验收、分层考虑组合。安全侧从测模型输出转向测业务全流程的可被攻击步骤和运行时控制。两类评测通过CI合并前检查和生产观测形成完整流程,在概率性系统前提下获得可管理质量保证和安全保证。

 400-607-0568