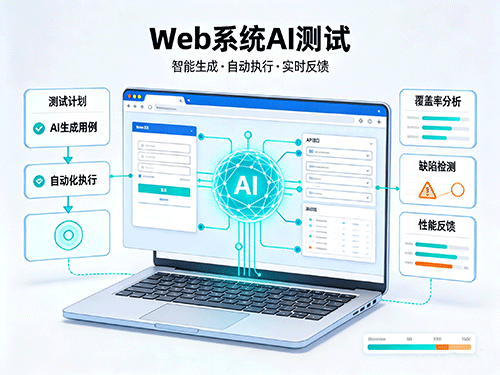
当前Web系统AI自动化测试的现实不是AI接管测试,而是确定性测试底座加旁路AI增强层加人工断言和门禁。 2026年的落地数据也说明这一点:AI测试被大量组织列为优先事项,但真正在重要的工作流全面应用的仍是少数,平均自动化率约四成,用例编写和维护仍是最大短板。
先划清当前AI实际能做什么。适合交给AI的,主要是四类:把QA用自然语言描述的场景转译成可运行的Playwright/pytest代码骨架;元素定位失败时,根据页面可访问性快照重新推理选择器;测试失败后自动采集截图、DOM快照和traceback,让LLM给出根因假设,缩短排错时间;从PRD或需求文档中提取功能点、边界条件和异常场景,生成结构化测试重点。这些步骤的共同点是:AI输出需要人审,但能显著减少体力劳动。字节的NL2Test实践可作为参考:生成用例中85.4%能进入CI/CD,新增用例平均约25%来自Agent生成,个别团队峰值超过50%,但定位仍是用例转译,不是替代测试设计。
当前不宜交给AI独立完成的,也要确定:断言和门禁决定不能交给LLM;复杂业务规则的正确性判断不能交给AI,真实踩坑案例里AI只证实订单生成成功,漏掉优惠券金额算得对不对;证实码、扫码登录、SSO跳转这类环境障碍,不要期待Agent自己学会处理,应在环境层做测试专用配置;模块间副作用和集成场景仍依赖人工设计。某电商AI客服上线后约15%合法咨询被误判为恶意请求,根因就是模块单独测试都过、模块间副作用没包括。这个边界的现实含义是:框架目的不是去人化,而是把人从编写和修复中释放出来,集中到测试方法、断言设计和风险判断上。
架构上比较好的底座是Playwright加pytest,再加一个旁路AI增强层,而不是从零建AI原生测试平台。Playwright提供确定性浏览器控制和可访问性快照,pytest提供成熟用例组织、fixture、参数化、重试、并行和CI集成。AI层只在语义模糊步骤介入,不接管整条链路。定位方法必须语义化优先,强制优先使用getByRole、getByLabel、getByText,CSS和XPath作为例外;只有语义化定位失败才触发AI修复。这样大部分用例不消耗LLM调用,成本和稳定性都可控。AI层必须支持无API Key也能跑的降级方式,因为LLM API可能限流、欠费或在CI不可达;如果AI层不可降级,一个非测试原因就能让整条链路瘫痪。登录态复用要在框架层解决:登录一次保存cookies和localStorage,用例间复用;证实码在测试环境配置白名单或固定证实码,扫码登录提供测试专用绕过通道。这些手段不优雅但有效,比让AI学处理证实码现实得多。断言要分层:可以有LLM做语义合理性辅助检查,但合入和阻塞门禁必须由确定性硬断言驱动。纯AI驱动的全量回归可能遗漏至少三成场景,门禁不严,自动化跑得再多也只是制造通过的幻觉。

 400-607-0568